一、实验目标
输入一张图片,判断是否异常,并标出异常区域。这里的定位指图像中的位置,不涉及三维坐标或小车导航。
- 跑通基线,理解特征提取与正常参考匹配。
- 训练至少两个自定义专家和一个路由器,根据图像选择 1~2 个专家。
- 完成对比与消融,分析检测、定位效果及运行成本。
术语说明
专家是处理图像特征的算法模块;基础专家 base由平台提供并保持冻结;自定义专家是本次实验实现和训练的模块。路由器负责选择专家,Top-1 / Top-2 分别表示选一个或两个。正常参考库用于匹配,阈值由独立正常校准集确定。
二、提供内容与实现任务
冻结 ResNet18、基础专家 base、起始工程、六类数据划分、统一接口与评价规则。
至少两个自定义专家、一个路由器,以及训练、参考库重建、校准、保存与重载流程。
一张图片是怎样完成异常检测的?
公共骨干负责提取特征;基础专家和自定义专家负责处理这些特征,它们是不同模块。
候选专家池(至少3个;每张图不是全部执行)
例如:本帧选择“基础专家+自定义专家2”,未选中的专家不参与本帧计算。
公共骨干每张图都要运行;基础专家是否参与这一帧,由路由器决定。两者虽然都保存在 teacher/base.pt 中,但不是同一个模块。
以 jetson003 为目标的组件配置要求
本课程以 jetson003 的现有环境为部署基准;组件应适配小车,不要求为组件升级车端系统或全局依赖。服务器数据评测用于检查算法,车端试运行用于确认实际兼容性与资源占用。以下限制针对整个组件,不是单个专家。文件大小与运行内存是两种不同指标:ZIP很小,也可能在运行时占用大量内存。
| 检查项目 | 服务器数据评测 | jetson003远程测试 |
|---|---|---|
| 整个提交方案 ZIP | ≤128 MiB(包括模型权重、配置、源码及包内其他文件) | 与服务器上传限制相同 |
| 整个组件解压大小 | ≤256 MiB,最多128个文件 | 组件部署磁盘预算≤512 MiB;还需计入框架文件 |
| 组件峰值运行内存 | ≤2 GiB(组件及其子进程合计,包含公共骨干、专家、参考库、中间特征和运行开销) | ≤2 GiB(与服务器采用相同组件预算,须车端实测验证) |
| 显存 / GPU | CPU评测,不提供GPU;不得依赖CUDA运行 | 当前仅开放CPU配置,不使用GPU显存;CUDA组件暂未开放验证 |
| CPU | 最多2核 | 最多2线程 |
| 系统与Python | 使用平台固定的CPU评测环境;接口与算法保持一致,不能以服务器运行代替ARM64验证 | ARM64/aarch64 · Ubuntu22.04.5 · Python3.10.12 |
| 车端依赖基准 | 提交源码须兼容右侧车端版本;服务器现有评测环境暂不变更 | PyTorch2.7.0、torchvision0.22.0、NumPy1.26.4、Pillow9.0.1、SciPy1.15.3、scikit-learn1.7.2 |
| 网络与依赖 | 离线运行,不在评测时联网下载模型或安装依赖 | 离线运行;依赖须与车端环境兼容 |
jetson003整机约8GB CPU/GPU共享内存,并非另有8GB独立显存。当前CPU组件的GPU显存使用为0;以后开放CUDA时,仍需将CPU与GPU占用合并核算,不能各自按8GB申请。
另需遵守模型预算:全部自定义可学习参数合计≤10万个;每点位自定义专家、路由及融合状态≤2 MiB;相关参考向量总数≤2048,每个向量≤96维;正式输出特征维度为32。冻结公共资产也计入实际部署体积及运行开销。
当前自动检查范围:服务器执行3 GiB容器总内存硬限制;组件峰值≤2 GiB是两端统一的适配要求,当前尚未自动测量并判定组件及其子进程的峰值,不能将容器评测通过视为已满足此项。车端2 GiB内存与512 MiB磁盘仍属配置预检预算,尚未完成车端隔离试运行。静态通过不代表实车可部署。当前待适配项属于课程公共框架:旧示例声明Pillow≥10、<13,并使用车端Pillow9.0.1没有的Image.Resampling接口。应提供兼容实现(例如兼容选择Image.BILINEAR),完成框架、模板与车端验证后再发布适配版;不要仅放宽版本声明。现有发行包和检查规则暂时保留,旧包的未通过状态不会因此自动解除。
基础专家与冻结基座下载
平台已提供 teacher/base.pt,包含冻结 ResNet18 和六类基础专家状态。组件模板中已经包含同版本资产;也可单独下载基础专家包(49.2 MiB),配合组件模板使用。
基础专家保持冻结;在此基础上训练自定义专家和路由器。它与已训练完整参考组件不同,不是可直接上传的最终提交包。
下载范围已调整:仅含3093张正常训练、180张正常适应、326张正常校准图片。249张开发评测图片及标注不再提供下载;服务器仍按原规则评测。此前已公开的数据不视为全新隐藏测试。
三、数据与训练范围
使用 VisA 与 MVTec LOCO AD 各三类图像。六类指物品场景,分别包含外观缺陷或数量、组合、位置关系异常。
| 数据集 | 品类 | 重点 |
|---|---|---|
| VisA | candle、capsules、pcb1 蜡烛、胶囊、电路板 | 外观缺陷与区域定位 |
| LOCO | pushpins、screw_bag、splicing_connectors 图钉分格容器、螺钉袋、导线连接器 | 逻辑异常与结构异常 |
查看六类图像:正常 / 异常 / 区域标注
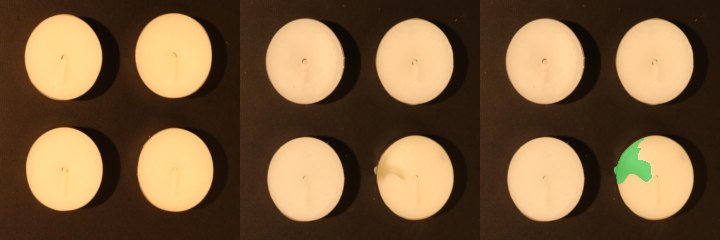
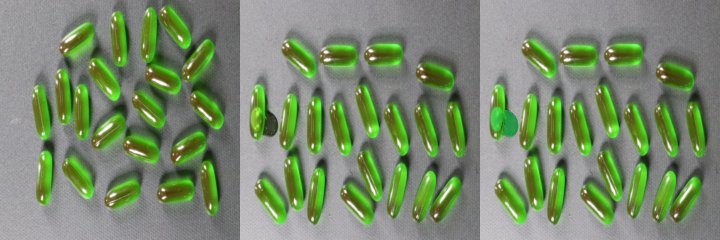
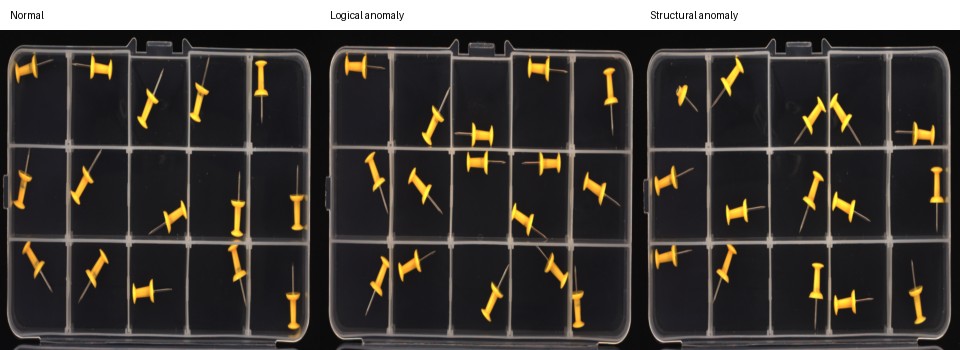
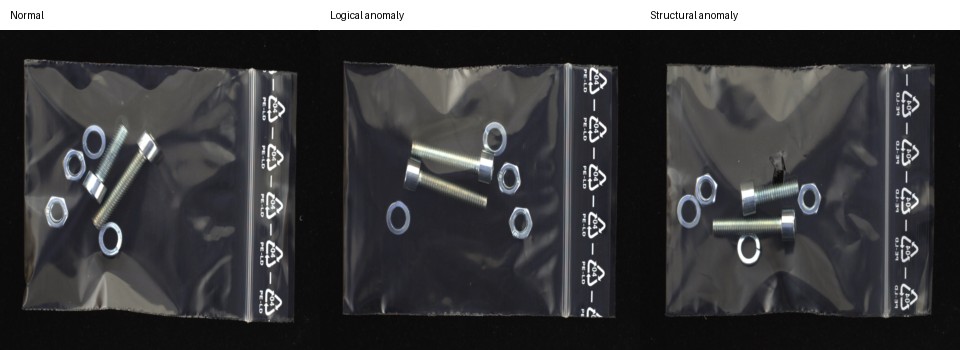
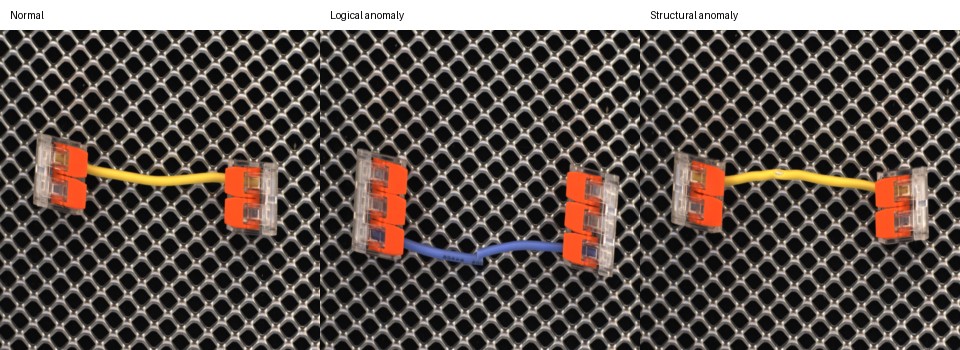
图例来自本次发放的数据,完整数据与角色数量见数据与代码。
| 划分 | 原图数量 | 用途 |
|---|---|---|
| 正常训练 | 3093 | 拟合专家与正常建模 |
| 正常适应 | 180 | 训练路由及允许的明暗、阴影适应 |
| 正常校准 | 326 | 独立确定阈值 |
| 本地开发验证 | 144(正常72、异常72) | 独立公开开发集;模型选择、对照与失败分析 |
| 服务器开发诊断 | 249(正常107、异常142) | 既有诊断与榜单;非保密考试 |
训练边界:开发异常与 mask 不得用于拟合、正常建库或阈值寻优。开发图按常规、偏暗×0.7、偏亮×1.3、中部阴影×0.7四种条件评测,共996次推理。当前为公开图像划分,独立现场采集为选做。
四、实现流程
正式框架支持默认关闭的light-preprocess-v1:按类别配置固定90°倍数旋转及0.8–1.2亮度/对比度。旋转须声明方向不变性。配置随模型绑定,训练、建库、校准与推理保持一致;热图恢复原图坐标,耗时计入评测,仍只运行一次骨干。配置入口与命令见数据代码页。修改后必须完整重训,不能只编辑已有权重或提交清单。
- 接入特征:公共程序将输入处理为320×320,运行一次冻结 ResNet18。专家的
embed(features, context)返回float32 [1,40,40,32],设备一致且数值有限。 - 训练专家与路由:保留冻结 base,至少训练两个自定义专家。
logits(features, context)返回[1,E],E含base,顺序与配置一致。只执行选中的专家,再归一化融合。 - 建库并校准:按候选策略建立融合正常参考库,用独立正常校准图确定图像与像素阈值。更新专家或路由后,重新建库与校准。
- 检查并评测:保存配置与日志,在全新进程重载模型,先完成本地144图四条件576次推理,再上传执行服务器996次诊断。两套数据不同,分数分别报告。
专家数量、每张图的处理流程与资源限制
- 先准备至少3个专家:保留平台提供的1个基础专家,再实现至少2个自定义专家。“最多两个”不是限制专家总数。
- 每张图只选1个或2个专家:路由器从专家池里选择本次要使用的专家。Top-1表示选1个,Top-2表示选2个;没有选中的专家不参与本次计算。例如,有“基础、位置、方向”3个专家时,本次可以选“基础+方向”,下次可以选“位置+方向”。
- 公共特征只提取一次:每张图先经过一次冻结的公共骨干,再交给选中的专家处理,最后将特征融合并进行一次参考匹配。不要重复运行骨干、额外调用视觉大模型,也不要用异常分数或热力图代替接口要求的特征。
- 每个点位的存储限制:自定义专家、路由器及融合相关状态合计不超过2 MiB;相关参考库和自定义原型合计不超过2048个向量,每个向量最多96维。专家正式输出的特征维度固定为32。
- 整个模型的训练参数限制:全部点位的自定义网络、路由器和其他可学习张量,合计不超过10万个参数。平台提供的冻结资产单独列出;报告中还需写明完整部署包大小和实际推理耗时。
- 结果解释要准确:路由权重表示融合时的占比,不表示专家的正确率;异常分数未经校准,不能直接称为异常概率。具体检查以当前发行包的规则为准。
五、对比与评价
| 实验 | 比较内容 |
|---|---|
| 基线与专家 | 仅base、各单专家、完整方法 |
| 融合与路由 | 固定融合、Top-1、Top-2 |
| 消融 | 移除或替换一个专家,其他条件一致 |
| 稳健性与成本 | 六类四条件的误报、漏检、定位、平均/P95耗时、调用次数与存储 |
比较时保持数据、输入尺寸、骨干和设备一致。展示至少三个失败案例,性能变好、持平或下降均如实报告。全专家融合仅作为诊断对照,单独说明开销。
评价细节与数据来源
输出图像级异常分数、二分类与区域;报告图像级AUROC及适用的定位指标。VisA与结构异常采用IoU;LOCO逻辑异常采用课程饱和区域覆盖与区域外误报惩罚,不等同于官方sPRO/AUC。按六类宏平均,并分别展示VisA外观、LOCO结构与逻辑结果,旧三类成绩不与新版混排。
既有训练与服务器诊断角色共3848张原图;新增本地开发144图与其及教学30图按解码像素隔离。VisA保留原划分,LOCO每类从正常训练图划出30张适应,正常validation用于校准,开发每类固定20正常、20逻辑、20结构。正常训练包不附带完整LOCO测试集;另发144图本地开发包与标注,供模型选择但不拟合专家/路由/参考库或寻优正式阈值。允许的正常变化及衍生伪异常以课程配置为准。
VisA来源:Amazon Science,CC BY 4.0;LOCO来源:MVTec,CC BY-NC-SA 4.0。遵守许可,保留下载包中的来源与论文引用。
六、提交材料
- 提交源码:专家、路由、训练、建库、校准与推理程序,附依赖和启动说明。
- 模型与配置:权重、参考库、专家顺序、Top-1/Top-2策略与各类阈值。
- 实验记录:数据角色清单、训练与校准日志、本地576次与服务器996次逐图结果(分开记录);记录分数、阈值、判断、热力图、区域、专家权重与耗时。
- 实验报告:基线、对比、消融、至少三个失败案例和资源开销。
从左侧“提交方案”上传并检查,在“数据评测”查看结果,在“实验报告”保存报告正文和附件,在“远程测试”查看现场测试入口。数据和打包命令见独立工作区的“数据代码”。上传检查通过不代表检测效果达标;现场巡检为选做,另交采集与验证记录。