可评测方案
服务器可评测与jetson003远程配置预检分别显示。当前课程版本中已通过源码审核的组件可发起评测;模型合同、资源预算与重载一致性仍在运行时检查。点击“前往数据评测”后再确认开始。
登录后查看可评测方案。
视觉巡检异常检测与定位 · 实验工作区
上传组件、检查运行规范,并在本页保存报告正文或附件。
下载本题组件模板,完成专家与路由器训练、校验并打包后上传。若只想验证上传与评测流程,可直接使用已训练的参考组件。
模板含专家与路由器接口、训练配置、冻结基座、数据划分清单、运行校验与 build_submission.py 打包脚本。它是开发工程,不能把 starter.zip 原样当作训练完成的组件上传。
python build_submission.py --model trained/model.pt --name 我的课程组件 --output submission.zip
本题使用实验一专用 MoE 组件协议与 CPU 评测环境,不能直接使用实验二的 RGB+描述检测模板。提交限制仍为 ZIP 最大128 MiB、解压后最大256 MiB;源码修改按原准入规则处理。
基础专家已提供,无需从零训练:teacher/base.pt 包含冻结 ResNet18 和 candle、capsules、pcb1、pushpins、screw_bag、splicing_connectors 六类的 base 状态。组件模板已包含同版本文件,完整下载模板后无需重复下载。
训练时加载 teacher/base.pt,并保留 config.json 的首项 {"name":"base","type":"teacher_base","config":{}}。你需要实现并训练至少两个自定义专家和路由器,再重建参考库、校准阈值并打包;基础专家和冻结骨干保持不变。
单独的基础专家包是开发依赖,不能直接当成完整组件上传;“可评测参考组件”则是已训练的多专家参考方案。包内 README.md 提供加载命令和适配步骤。
下载基础专家包 SHA-256 校验值本课程以 jetson003 的现有环境为部署基准;组件应适配小车,不要求为组件升级车端系统或全局依赖。服务器数据评测用于检查算法,车端试运行用于确认实际兼容性与资源占用。以下限制针对整个组件,不是单个专家。文件大小与运行内存是两种不同指标:ZIP很小,也可能在运行时占用大量内存。
| 检查项目 | 服务器数据评测 | jetson003远程测试 |
|---|---|---|
| 整个提交方案 ZIP | ≤128 MiB(包括模型权重、配置、源码及包内其他文件) | 与服务器上传限制相同 |
| 整个组件解压大小 | ≤256 MiB,最多128个文件 | 组件部署磁盘预算≤512 MiB;还需计入框架文件 |
| 组件峰值运行内存 | ≤2 GiB(组件及其子进程合计,包含公共骨干、专家、参考库、中间特征和运行开销) | ≤2 GiB(与服务器采用相同组件预算,须车端实测验证) |
| 显存 / GPU | CPU评测,不提供GPU;不得依赖CUDA运行 | 当前仅开放CPU配置,不使用GPU显存;CUDA组件暂未开放验证 |
| CPU | 最多2核 | 最多2线程 |
| 系统与Python | 使用平台固定的CPU评测环境;接口与算法保持一致,不能以服务器运行代替ARM64验证 | ARM64/aarch64 · Ubuntu22.04.5 · Python3.10.12 |
| 车端依赖基准 | 提交源码须兼容右侧车端版本;服务器现有评测环境暂不变更 | PyTorch2.7.0、torchvision0.22.0、NumPy1.26.4、Pillow9.0.1、SciPy1.15.3、scikit-learn1.7.2 |
| 网络与依赖 | 离线运行,不在评测时联网下载模型或安装依赖 | 离线运行;依赖须与车端环境兼容 |
jetson003整机约8GB CPU/GPU共享内存,并非另有8GB独立显存。当前CPU组件的GPU显存使用为0;以后开放CUDA时,仍需将CPU与GPU占用合并核算,不能各自按8GB申请。
另需遵守模型预算:全部自定义可学习参数合计≤10万个;每点位自定义专家、路由及融合状态≤2 MiB;相关参考向量总数≤2048,每个向量≤96维;正式输出特征维度为32。冻结公共资产也计入实际部署体积及运行开销。
当前自动检查范围:服务器执行3 GiB容器总内存硬限制;组件峰值≤2 GiB是两端统一的适配要求,当前尚未自动测量并判定组件及其子进程的峰值,不能将容器评测通过视为已满足此项。车端2 GiB内存与512 MiB磁盘仍属配置预检预算,尚未完成车端隔离试运行。静态通过不代表实车可部署。当前待适配项属于课程公共框架:旧示例声明Pillow≥10、<13,并使用车端Pillow9.0.1没有的Image.Resampling接口。应提供兼容实现(例如兼容选择Image.BILINEAR),完成框架、模板与车端验证后再发布适配版;不要仅放宽版本声明。现有发行包和检查规则暂时保留,旧包的未通过状态不会因此自动解除。
Jetson Orin Nano Super · 6核 · ARM64 · Python3.10。配置快照正在加载。
manifest.json中的deployment用于声明上述预算和依赖。上传与创建评测时自动预检;快照超过24小时需重新采集,包重检不会刷新小车配置。
下载配置声明示例 JSON完整题目:基于混合专家模型的视觉巡检异常检测与定位系统设计。保留冻结基座,至少两个学生专家;正式策略为Top-1或Top-2。归档完成不代表模型准入,运行前仍检查模型合同、资源预算和重载一致性。
ZIP展开最多256 MiB、128个文件;每账号归档1 GiB/50版本、同时一个上传、两个待处理任务,每小时最多6次评测。完整SHA-256保存在每个模型版本详情中。
打开完整实验任务书 →服务器可评测与jetson003远程配置预检分别显示。当前课程版本中已通过源码审核的组件可发起评测;模型合同、资源预算与重载一致性仍在运行时检查。点击“前往数据评测”后再确认开始。
登录后查看可评测方案。
上传后保留程序包与校验信息;新源码需完成审核。结构检查不代表模型准入或检测效果达标,具体原因可在版本详情查看。
登录后查看自己的程序包。
正在读取课程发行版…
VisA点位为candle、capsules、pcb1;LOCO点位为pushpins、screw_bag、splicing_connectors。VisA图例为正常、异常、标注;LOCO图例为正常、逻辑异常、结构异常;训练内容见场景与数据要求。
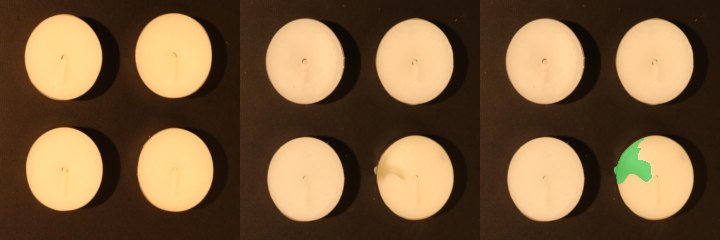
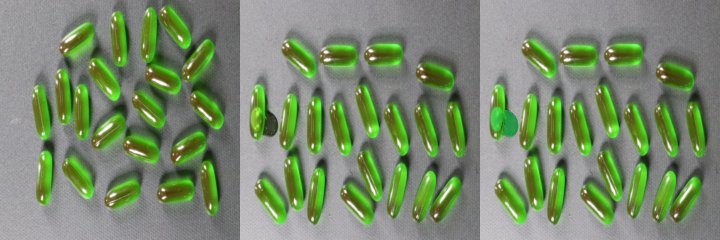
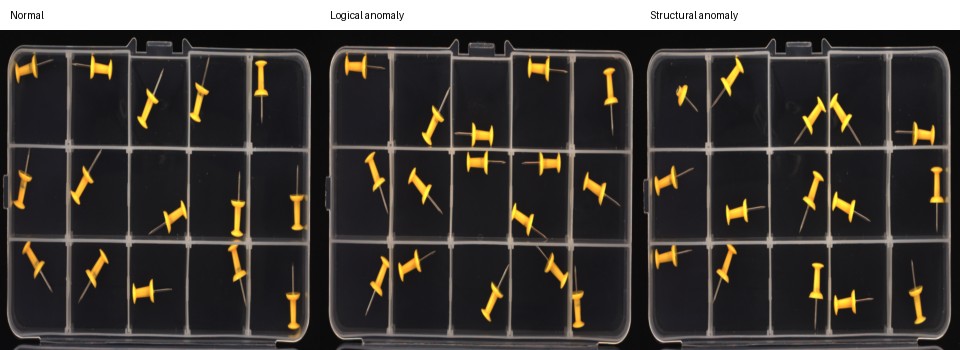
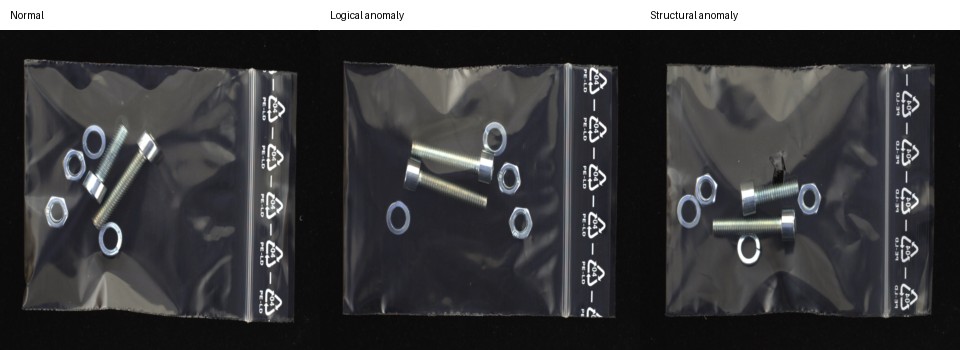
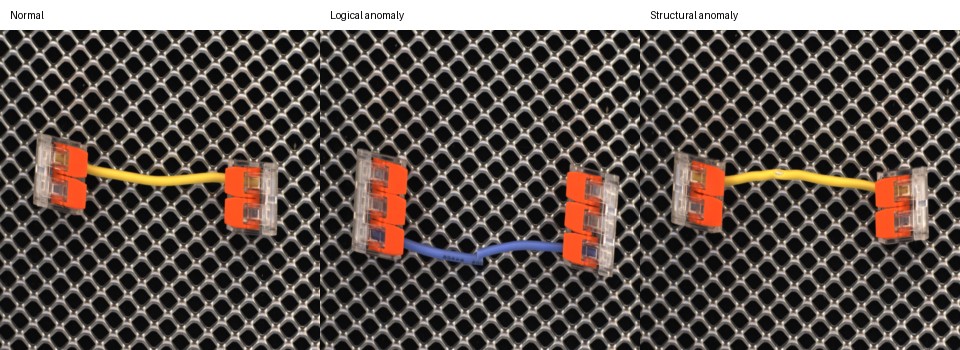
来源:VisA / Amazon Science。数据许可CC BY 4.0,新增 MVTec LOCO AD,许可CC BY-NC-SA 4.0。完整说明见下载包LICENSE-VisA、LICENSE-LOCO.txt与来源元数据。示例不能替代完整数据或现场独立验收。
正式训练和CPU评测共用相同处理:0/90/180/270度整图旋转,亮度与对比度系数0.8–1.2。仍只运行一次冻结ResNet18;热力图及定位框恢复至原图坐标,预处理计入总耗时。
旋转请按类别配置。多类别或更复杂组合可编辑下载的JSON,由训练工具统一校验。配置是模型训练的一部分,不能对已有模型临时勾选后直接生效。
python pg01_configure_preprocessing.py --config config.json --policy preprocessing.json --output config-pp.json
course-feature train --teacher teacher/base.pt --config config-pp.json --train train.csv --adapt adapt.csv --calibration calibration.csv --output trained-pp --device cpu
course-feature check --checkpoint trained-pp/model.pt --teacher teacher/base.pt --rules teacher/rules.json --roles teacher/roles.json --source-root . --output check-pp.json
python pg01_evaluate.py --checkpoint trained-pp/model.pt --manifest local_development/development.csv --output local_runs/pp_top2 --mode top2
python build_submission.py --model trained-pp/model.pt --name 我的预处理方案 --output submission-pp.zip
请先下载新版组件模板。旧模型不含预处理字段时继续走原路径;旧记录保留,新旧运行框架不混作同版本对比。教师默认参考仍不启用预处理,不保证开启后一定提分。
框架修订:。这是课程CPU隔离评测支持,不代表jetson003真机兼容验证已完成。
新增六类144张真实图像:每类12正常、12异常;LOCO异常由6结构和6逻辑组成。提供原图、区域标注及独立逻辑区域。与正常三角色、教学30图和服务器249图按解码像素哈希隔离,不宣称采集会话隔离。
本地数据版本:pg01-local-development-v1-20261101。允许用于模型/配置选择与失败分析;不将真实异常或mask拟合专家、路由、参考库,也不根据其标注寻优正式阈值。教学样例仍仅供认识任务。
下载新版组件模板,正常训练包解压到工程根目录;本地开发包保留local_development/子目录。原正常CSV不覆盖。
python pg01_doctor.py > environment.json
先执行下方正常训练与check命令,再检查完整性、角色隔离和模型合同:
python pg01_evaluate.py --checkpoint trained/model.pt --manifest local_development/development.csv --output local_runs/preflight --preflight-only
python pg01_evaluate.py --checkpoint trained/model.pt --manifest local_development/development.csv --output local_runs/top2_seed42 --mode top2
将--mode改为top1或base,并使用不同输出目录,完成对照。结果包含metrics.json、逐图CSV/JSONL及report.html失败可视化;已有目录不会覆盖。
本地144图运行576次;服务器249图运行996次。两套原始诊断分不能直接比较,本地不换算教师60榜单积分。新版打包工具自动读取模型主策略,不允许将Top-2模型只改清单标成Top-1;已有ZIP不会覆盖。不要把公开开发集当作保密考试;最终课程总分与独立考试尚未启用。
缺文件:分别解压训练包与开发包;SHA不符:重新下载对应包,不能编辑CSV跳过校验;输出目录已存在:更换目录保留旧结果;角色重叠:不得将开发图片加入正常拟合清单;模型状态不一致:重新训练、建库、校准;上传暂停:重新选择同一ZIP续传;显示检查中:文件已保存,不要重复创建上传。
通用course-feature evaluate不是完整课程评分工具;本地课程验证请用pg01_evaluate.py,它使用相同的结构/逻辑定位算法。本机耗时与统一服务器计时口径不同,不能直接比较P95。
| 点位 | 正常训练 | 正常适应 | 正常校准 | 开发:正常 / 异常 |
|---|---|---|---|---|
| candle | 803 | 32 | 49 | 17 / 8 |
| capsules | 483 | 22 | 34 | 12 / 7 |
| pcb1 | 805 | 36 | 54 | 18 / 7 |
| pushpins | 342 | 30 | 69 | 20 / 40 |
| screw_bag | 330 | 30 | 60 | 20 / 40 |
| splicing_connectors | 330 | 30 | 60 | 20 / 40 |
| 合计 | 3093 | 180 | 326 | 107 / 142 |
训练用于拟合正常专家;适应用于课程允许的正常变化学习;校准用于冻结图像及像素阈值;开发集用于比较方法和分析失败案例。前三个角色只含正常图,不能将开发异常或mask用于拟合与阈值寻优。
开发249图在常规、偏暗×0.7、偏亮×1.3及中部阴影×0.7条件下评测,共996次。派生变化继承原图角色;当前按公开图像划分,不宣称独立采集会话隔离,也不构成保密考试。
解压起始工程,将数据包解压到同一目录,保留images/与三个正常角色CSV。建议Python 3.12,建立独立虚拟环境。
python -m venv .venv
source .venv/bin/activate
pip install -e .
围绕六类场景的空间结构、数量组合、局部纹理或全局外观设计专家和路由,保留教师资产;采用发放的正常角色训练,更新后重新建库与校准。
course-feature train --teacher teacher/base.pt \
  --config config.json --train train.csv --adapt adapt.csv \
  --calibration calibration.csv --output trained --device cpu
course-feature check --checkpoint trained/model.pt \
  --teacher teacher/base.pt --rules teacher/rules.json \
  --roles teacher/roles.json --source-root . --output check.json
python build_submission.py --model trained/model.pt \
  --name 我的课程方案 --output submission.zip
course_moe/            公共框架与教师评价
student_extensions/    学生专家与路由
teacher/               冻结base与统一规则
config.json            专家池、路由与主策略
train.csv / adapt.csv  允许的正常拟合数据
calibration.csv        独立正常校准
development.csv        公开开发诊断
images/                数据与区域标注
build_submission.py    课程包生成工具
submission.zip
├─ manifest.json
├─ model.pt
├─ README.md
├─ student_extensions/*.py
├─ training_log.json   可选
├─ calibration.json    可选
└─ config.json         可选
{"protocol":"liminal.workshop.anomaly_moe.v1",
 "release":"pg01-visa-loco-v1-20261024",
 "name":"我的课程方案",
"primary_mode":"top2"}平台为CPU两核、3 GiB内存、最长900秒;固定依赖、断网、只读、非root。暂不接受安装脚本或在线pip依赖。平台使用PyTorch 2.14.1、torchvision 0.29.1;其他环境先复核加载和数值。
结构检查通过后可提交隔离评测,结构校验不等于模型可运行或效果达标。若显示重载/形状/数值或资源错误,请先运行本地check,并重新生成与专家、路由一致的参考库和阈值。
参考包用于验证提交和评测流程;它的开发结果不保证MoE优于单专家。请保留真实消融和失败分析。
六类等权:常规光照下,各类AUROC与平衡准确率的均值。
六类等权:外观/结构用IoU;逻辑异常用饱和区域覆盖并惩罚背景误报。课程指标,非官方sPRO/AUC。
偏暗、偏亮、阴影等权,结合扰动检测能力和相对常规光照的性能保持率;随机水平或更差不得鲁棒分。
加权指标 W = 40×检测质量 + 35×定位质量 + 25×鲁棒质量。模型成绩 = min(100, 60×模型W / 教师固定W)。教师60分,满分100分;加权指标与最终模型成绩分别显示,不为指定模型调分。
对每类、每种扰动,设常规平衡准确率为 B₀,扰动平衡准确率为 B:鲁棒质量=max(0,2B−1)×min(1,B/B₀),B₀为0时保持因子取1。六类和三种扰动等权平均。超出随机水平的检测能力作为基础,性能下降进一步扣减;恒定输出不会因“稳定”获得高分。
规则:model-grade-40-35-25-v2。兼容版本的完整成功评测统一重新换算,原始检测25/定位15/鲁棒20的诊断与记录不覆盖;历史版本在分项完整时按最新公式换算为参考分,保留版本分组,不与当前版本直接比较。阈值仍仅用正常校准数据确定。运行失败、输出不完整或重复/重载不通过,无有效模型成绩。
当前教师定位能力较弱,按实际测得能力计分,不将其放大描述为成熟定位系统。效率、长时稳定性和报告另作诊断或评价,不追加到模型百分制;本地开发集不能套用服务器教师基准。独立现场考试尚未启用。
VisA + MVTec LOCO AD 六类:candle、capsules、pcb1、pushpins、screw_bag、splicing_connectors。训练包仅包含正常训练、适应与校准图片;另提供144张本地开发验证图及异常区域标注,用于方法选择和失败分析。原249张服务器诊断图不包含在这两个包中。
可下载:正常训练3093张 · 正常适应180张 · 正常校准326张。另下载144张正常/异常本地开发图和标注。249张服务器诊断图保持独立。
版本:pg01-visa-loco-v1-20261024。评测图片此前曾公开;它们仍用于公开开发诊断,不是从未披露的隐藏考试。本地开发集独立,服务器评测流程与历史记录不变。使用须遵守原始数据集许可证。
选择组件版本后点击“开始评测”;准入、排队和结果可在下方查看。
查看真实运行、比较版本,找到误报、漏检和定位失败的原因。
登录后查看自己的评测记录。还没有记录时,可先下载参考包,完成上传与准入,再运行开发集。
仅结构检查不会批准新Python源码。联系教师核对当前提交包SHA-256与依赖;修改源码须重新提交版本。
先查看真实错误,再复核教师资产、张量形状/数值、资源预算,以及专家与路由更新后的参考库和阈值。使用本地check重现。
同一账号最多两个待处理任务。队列按顺序评测;推理耗时与排队/加载时间分开。请刷新任务,避免重复提交耗尽配额。
按点位和条件筛选,区分正常误报、异常漏检和低IoU定位;再比较单专家、固定融合、Top-1和Top-2,保留负面结论。
课程成绩仅本人和管理员可查看,教师参考固定为60分基准。
登录已审核的课程成员账号后查看榜单。
检测40%、定位35%、鲁棒性25%。模型成绩=min(100,60×模型加权指标/教师固定加权指标)。教师60分、学生最高100分;兼容完整结果统一按model-grade-40-35-25-v2换算。旧原始诊断保留供追溯,历史不兼容版本按版本分组展示。
仅纳入同数据、教师、评价器与运行版本下,通过准入、重复调用和重新加载检查的完整成功评测。同一提交包哈希只列最近一次兼容评测;相同分数并列。平均时延按单张图片计时,从评测程序开始读取输入图像,到检测组件返回异常分数与热力图,再对本次评测的所有样本取平均。结果编码、传输、排队和模型启动另计。平均时延和 P95 用于参考,不参与积分排序。
本榜为公开开发集对比,不是正式课程总成绩。所有已审核课程成员可见模型名称与成绩;成员的模型文件、报告及私人评测详情仍按原权限访问。
选择已完成的数据评测,核对组件版本与实验结果,再进入智舱配置试验场和载体。
尚未选择评测记录。
测试入口:灵眸智舱
实验一的现场组件部署与预约尚未接入。可先进入智舱查看试验场、载体与硬件能力;数据评测完成不代表组件已在载体部署。
进入灵眸智舱 →打开智舱不会自动加载所选组件,也不会启动设备。现场测试需先完成组件适配、配置与部署。
让模型版本、数据边界、真实实验与结论一一对应。